 КиберЩит
Тёплый резерв в облаке: как восстановить сервис после сбоя
📋 Кратко
Тёплый резерв возвращает облачный сервис после сбоя быстрее обычного бэкапа. Резервная среда уже подготовлена, а данные регулярно поступают на другую площадку. Разбираем RTO и RPO, холодный и горячий резерв, репликацию, переключение трафика и контроль безопасности. Отдельно показываем, почему копии в том же дата-центре не спасают и зачем регулярно проверять восстановление.
Облачный сбой показывает разницу между наличием копии и готовностью к восстановлению. Файлы могут сохраниться, но сервис всё равно останется недоступным.
Тёплый резерв решает эту проблему. Он держит запасную среду почти готовой к запуску. Данные постоянно или часто обновляются в резервном контуре.
Главный вопрос звучит просто: сколько времени бизнес готов не работать. Второй вопрос — сколько последних данных допустимо потерять.
🔍 Что такое тёплый резерв
Тёплый резерв — это заранее подготовленная запасная среда для сервиса. В ней есть вычислительные ресурсы, сеть, настройки и копии данных.
Обычно серверы в такой среде не обслуживают постоянный поток пользователей. Они могут быть выключены или работать с небольшой нагрузкой. При сбое команда запускает их и направляет трафик на резервную площадку.
Важна не только техника. В резервной среде должны работать доступы, мониторинг, журналы и процедуры запуска. Иначе команда получает набор ресурсов, но не работающий сервис.
Тёплый резерв занимает промежуточное положение. Он быстрее холодного восстановления и дешевле полностью горячей схемы. Цена зависит от объёма постоянно работающих ресурсов и частоты обновления данных.
Сразу проверьте, что именно входит в резерв. Зафиксируйте вычисления, сеть, хранилище, базы данных, ключи доступа и порядок запуска.
📊 Холодный, тёплый и горячий варианты
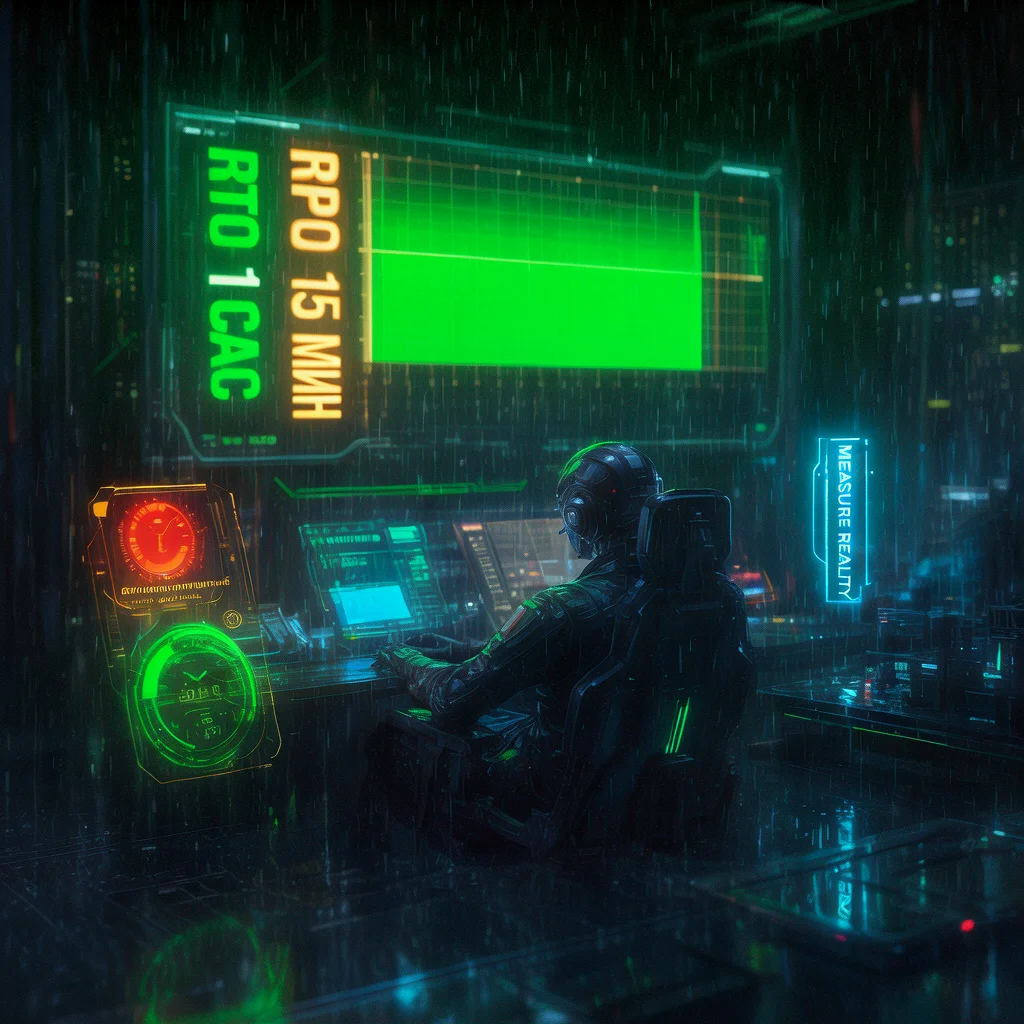
Холодный резерв хранит данные и инструкции, но не готовую работающую среду. После сбоя нужно найти мощности, развернуть серверы, перенести данные и проверить запуск.
Такой подход подходит системам, простой которых бизнес переносит несколько дней. В описанном случае подъём из копий обычно занимает несколько дней. При дефиците мощностей процесс растягивается на недели.
Тёплый резерв держит запасную площадку подготовленной. Данные поступают туда заранее, а серверы запускаются после решения о переключении.
Горячий резерв работает почти одновременно с основной средой. Пользовательский трафик обслуживают обе площадки или одна из них сразу принимает нагрузку при сбое.
Горячая схема обычно требует больше ресурсов и сложнее в управлении. Она не защищает автоматически от ошибочного удаления данных. Ошибка может быстро распространиться на обе площадки.
Холодный резерв — данные и инструкции, восстановление занимает дни или дольше.
Тёплый резерв — подготовленная среда и обновляемые данные, запуск занимает часы.
Горячий резерв — почти готовая работающая копия, переключение занимает минуты или короткое время.
Не выбирайте режим только по цене. Сначала определите допустимый простой и допустимую потерю данных.
⏱️ RTO и RPO: две цифры для восстановления
RTO показывает допустимое время восстановления. Это период от обнаружения сбоя до возвращения сервиса в рабочее состояние.
RPO показывает допустимую потерю данных. Это период между последним надёжным состоянием и моментом сбоя.
Например, компания может установить RTO в один час и RPO в пятнадцать минут. Тогда сервис нужно вернуть за час, а потеря данных не должна превышать пятнадцать минут.
Эти значения влияют на архитектуру. Малый RPO требует частой репликации или постоянной передачи изменений. Малый RTO требует заранее подготовленных ресурсов и короткой процедуры переключения.
Цели нужно устанавливать отдельно для каждой системы. Интернет-магазин, учётная система и архив могут иметь разные требования.
Проверьте RTO и RPO на практике. Запишите реальное время запуска и фактический объём потерянных изменений.
🌍 Почему одной копии у провайдера недостаточно
Запасная площадка рядом с основной не всегда защищает от общего события. Обе площадки могут зависеть от одной инженерной инфраструктуры или одного поставщика.

В октябре атаки беспилотников вывели из строя три дата-центра Яндекса. Для клиентов это стало проверкой планов восстановления.
Одна компания хранила рабочие системы и копии в одном регионе. Запасная копия серверов находилась в соседнем дата-центре того же провайдера.
У площадок была разная инженерная инфраструктура. Но физически они стояли рядом. Восстановить ресурсы на прежней площадке быстро не получилось.
Компании пришлось переезжать. Подъём из копий обычно занимает несколько дней, но при одновременном спросе на мощности срок может вырасти до недель.
Риск подтверждает и другой известный случай. В марте 2021 года пожар в дата-центре в Страсбурге затронул клиентов, чьи копии хранились рядом с рабочими серверами.
Резервный контур должен учитывать общий риск. Это может быть другая зона, регион или независимый поставщик. Выбор зависит от требований бизнеса и условий договора.
🛠️ Из чего состоит архитектура тёплого резерва
Базовая схема включает основную площадку и резервную зону. В резервной зоне заранее создают сеть, вычислительные ресурсы и хранилища.
Между площадками работает репликация. Она передаёт изменения данных из основной среды в резервную. Частота передачи определяет возможную потерю данных.
Перед сервисами нужен механизм управления трафиком. Это может быть балансировщик или другой управляемый слой маршрутизации. Он направляет запросы на активную площадку.
После сбоя команда запускает резервные серверы. Затем она меняет маршрут трафика и проверяет доступность приложения.
Отдельно нужно подготовить зависимости. К ним относятся базы данных, очереди, хранилища файлов, доменные записи и внешние интеграции.
Если хотя бы одна зависимость остаётся на недоступной площадке, сервис не запускается полностью. Поэтому схема должна описывать не только серверы.
Нарисуйте карту зависимостей. Для каждого элемента укажите площадку, владельца, способ восстановления и контрольную проверку.
🔁 Синхронная и асинхронная репликация
Синхронная репликация подтверждает запись после передачи изменения в резервную систему. Основная и запасная копии почти совпадают.
Такой режим снижает риск потери последних данных. Но он зависит от задержки между площадками и качества канала.
Если резервная площадка далеко, ожидание подтверждения замедляет операции. При проблемах связи сервис может испытывать задержки.
Асинхронная репликация сначала подтверждает запись в основной системе. Резервная копия получает изменение позже.
Этот режим обычно лучше переносит расстояние. Но при сбое можно потерять изменения, которые ещё не дошли до резерва.
Для оценки риска нужен показатель задержки репликации. Его следует наблюдать постоянно, а не проверять только после аварии.
Репликация не заменяет резервное копирование. Ошибка оператора, повреждение данных или вредоносное удаление может попасть в обе копии.
Настройте оповещение при росте задержки репликации. Также храните несколько исторических точек восстановления.
🛡️ Как защитить резервную среду
Резервная площадка содержит те же ценные данные, что и основная. Поэтому её нельзя считать менее важной или временной.
Доступ к резерву нужно отделить от обычной работы. Используйте отдельные роли и минимальные права. Администратор приложения не должен автоматически управлять всей резервной инфраструктурой.
Управление доступом включает многофакторную проверку. Критические действия нужно подтверждать отдельно и записывать в журнал.
Учётные данные для аварийного запуска нельзя хранить только на основной площадке. Иначе сбой лишит команду доступа к резерву.
Данные в передаче и хранении следует защищать шифрованием. Ключи нужно контролировать отдельно от самих копий.
Резервную среду полезно изолировать от обычного административного контура. Это снижает риск, что ошибка или компрометация основной площадки затронет резерв.
Сценарий с Graylog показывает важность защиты доступных интерфейсов. В период с мая по сентябрь 2026 года злоумышленник использовал Log4Shell в Graylog и добился выполнения команд как минимум на двух серверах.
На одном сервере находился кластер Elasticsearch с 6 833 058 документами. Доступ к журналированию и административным интерфейсам может раскрыть структуру данных даже без массовой выгрузки.
Проверьте доступы к резерву, обновления компонентов и журналы административных действий. Уберите публичный доступ там, где он не нужен.
🚨 Как обнаружить сбой и принять решение
Переключение начинается с обнаружения проблемы. Система мониторинга фиксирует недоступность, ошибки, рост задержек или потерю связи.
Одного сигнала недостаточно. Ошибка может быть локальной, а автоматический запуск резерва создаст новую проблему.
Команда сравнивает несколько признаков. Она проверяет основную площадку, репликацию, состояние данных и доступность внешних зависимостей.
После подтверждения сбоя назначается руководитель решения. Он фиксирует время события, выбранный сценарий и допустимую потерю данных.
Если причина неизвестна, автоматическое переключение может быть опасным. Оно способно запустить резерв при кратком сетевом сбое и вызвать конфликт данных.
Для критических систем полезно разделить автоматическое обнаружение и ручное подтверждение. Автоматика собирает признаки, а ответственный принимает решение.
Журналируйте каждое действие. Записывайте сигналы, решения, время переключения и результаты проверки.
🚀 Пошаговое переключение на тёплый резерв
Первый шаг — подтвердить, что основная среда действительно недоступна. Проверьте сервис с нескольких точек и сравните результаты мониторинга.
Второй шаг — остановить опасные операции на основной площадке. Это снижает риск расхождения данных при частичной доступности.
Третий шаг — определить последнюю подтверждённую точку репликации. Команда фиксирует время и возможную потерю изменений.
Четвёртый шаг — запустить резервные ресурсы. Сначала поднимаются сеть, хранилища и базы данных. Затем запускаются приложения и фоновые процессы.
Пятый шаг — проверить целостность данных. Сверьте контрольные показатели, записи операций и доступность ключевых функций.
Шестой шаг — изменить маршрут трафика. Балансировщик или другой механизм направляет пользователей в резервную среду.
Седьмой шаг — проверить сервис с точки зрения пользователя. Откройте основные сценарии, проверьте авторизацию и обмен данными.
Восьмой шаг — включить усиленный мониторинг. Отслеживайте ошибки, задержки, нагрузку, репликацию и действия администраторов.
- сбой подтверждён несколькими сигналами;
- ответственный принял решение;
- зафиксирована последняя точка данных;
- резервные ресурсы запущены;
- целостность данных проверена;
- трафик переключён;
- ключевые пользовательские сценарии работают;
- журналы и оповещения включены.
Сохраните этот порядок в эксплуатационной инструкции. Не полагайтесь на память команды во время аварии.
✅ Как проверять восстановленный сервис
Доступность страницы ещё не означает восстановление системы. Пользователь может войти, но не создать заказ или получить документ.
Проверка должна включать главные бизнес-сценарии. Выберите несколько операций, без которых сервис не приносит пользу.
Проверьте чтение и запись данных. Отдельно проверьте очереди, фоновые задания и обмен с внешними системами.
Сравните показатели с последней рабочей точкой. Ищите пропущенные операции, дубликаты и несогласованные записи.
Проверьте права доступа. После переключения администратор не должен получить лишние полномочия, а обычный пользователь — потерять нужные.
Зафиксируйте процент успешных проверок. Если часть сценариев не работает, сервис нельзя считать полностью восстановленным.
Составьте короткий набор автоматических проверок. Запускайте его после каждого тестового переключения.
🧪 Испытания и обновление инструкции
План восстановления нельзя считать рабочим без регулярных испытаний. В документе могут устареть адреса, роли, ключи и порядок запуска.
Проводите учения с понятной целью. Одно испытание проверяет запуск резерва, другое — целостность данных, третье — работу команды.
Сначала выполняйте безопасную проверку без полного отключения основной среды. Затем планируйте контролируемое переключение.
Измеряйте фактический RTO. Отдельно измеряйте задержку репликации и реальный RPO.
Проверяйте доступ к аварийным учётным данным. Команда должна найти их без зависимости от недоступной площадки.
После учения фиксируйте все расхождения. Укажите, что не сработало, кто исправляет проблему и к какому сроку.
Повторяйте тест после изменений в сети, базе, приложении или договоре с провайдером. Даже небольшое изменение может нарушить запуск.
- проверить задержку репликации;
- запустить резервную среду;
- переключить тестовый трафик;
- выполнить ключевые операции;
- проверить журналы и права;
- измерить время восстановления;
- обновить инструкцию по итогам.
Назначьте периодичность учений и владельца результата. Без ответственного проверка быстро превращается в формальность.
💰 Стоимость и ограничения тёплого резерва
Тёплый резерв требует постоянных расходов. Нужно оплачивать хранение, передачу данных, подготовленные ресурсы и мониторинг.
Часть ресурсов можно запускать только во время аварии. Но тогда растёт время восстановления и появляется зависимость от свободных мощностей.
Спрос на инфраструктуру может резко вырасти после крупного сбоя. В описанном случае поиск площадки и оборудования для многих клиентов растягивался на недели.
Поставка оборудования для замены может занимать до полугода. За несколько дней серверы и системы хранения подорожали на 10–15 процентов.
Облачный резерв также зависит от условий договора. В редакции пользовательского соглашения от 10 октября атаки с применением беспилотников и ракет относятся к форс-мажору.
При признании события форс-мажором убытки от простоя могут остаться на стороне клиента. Это зависит от конкретных условий договора.
Проверьте лицензионные ограничения и стоимость передачи данных. Отдельно оцените зависимость от одного поставщика.
📋 Итоговый план для компании
Начните с критичных сервисов. Для каждого укажите допустимый простой и объём данных, который можно потерять.
Затем опишите зависимости. В список входят базы, файлы, очереди, внешние интерфейсы, доступы и доменные записи.
Выберите место для резервной среды. Не ограничивайтесь соседним дата-центром того же провайдера без оценки общих рисков.
Настройте репликацию и отдельное резервное копирование. Репликация ускоряет запуск, а исторические копии помогают отменить ошибочные изменения.
Защитите резерв от основной среды. Разделите роли, включите многофакторную проверку, шифруйте данные и храните журналы.
Подготовьте сценарий переключения. Он должен содержать порядок действий, критерии решения и проверки после запуска.
Проведите испытание и измерьте результат. Если фактическое время выше цели, измените архитектуру или требования бизнеса.
В октябре 2026 года планы восстановления проверяют уже не на бумаге. Приблизительно один процент от 64 000 клиентов облака — это сотни организаций. Для каждой из них резерв становится рабочей системой только после реального теста.
Сделайте первую проверку сейчас: найдите последнюю копию, подтвердите место восстановления и запишите время запуска. Если ответ неизвестен, резерв ещё не готов.
📚 Читайте также
- Защита АСУ ТП: как доказать соответствие требованиям безопасности
- Квантовая угроза архивам: защита данных от атаки «сейчас собирай»
- Запрос на сброс пароля оказался атакой: расследование в IDM
- Публичное облако и АСУ ТП: как защитить ключи от цепной компрометации
- Антифрод против ИИ: почему согласованность сигналов важнее отпечатка
📖 Термины
IAM (Identity and Access Management) · Инцидент-реагирование · Облачная безопасность · Шифрование